


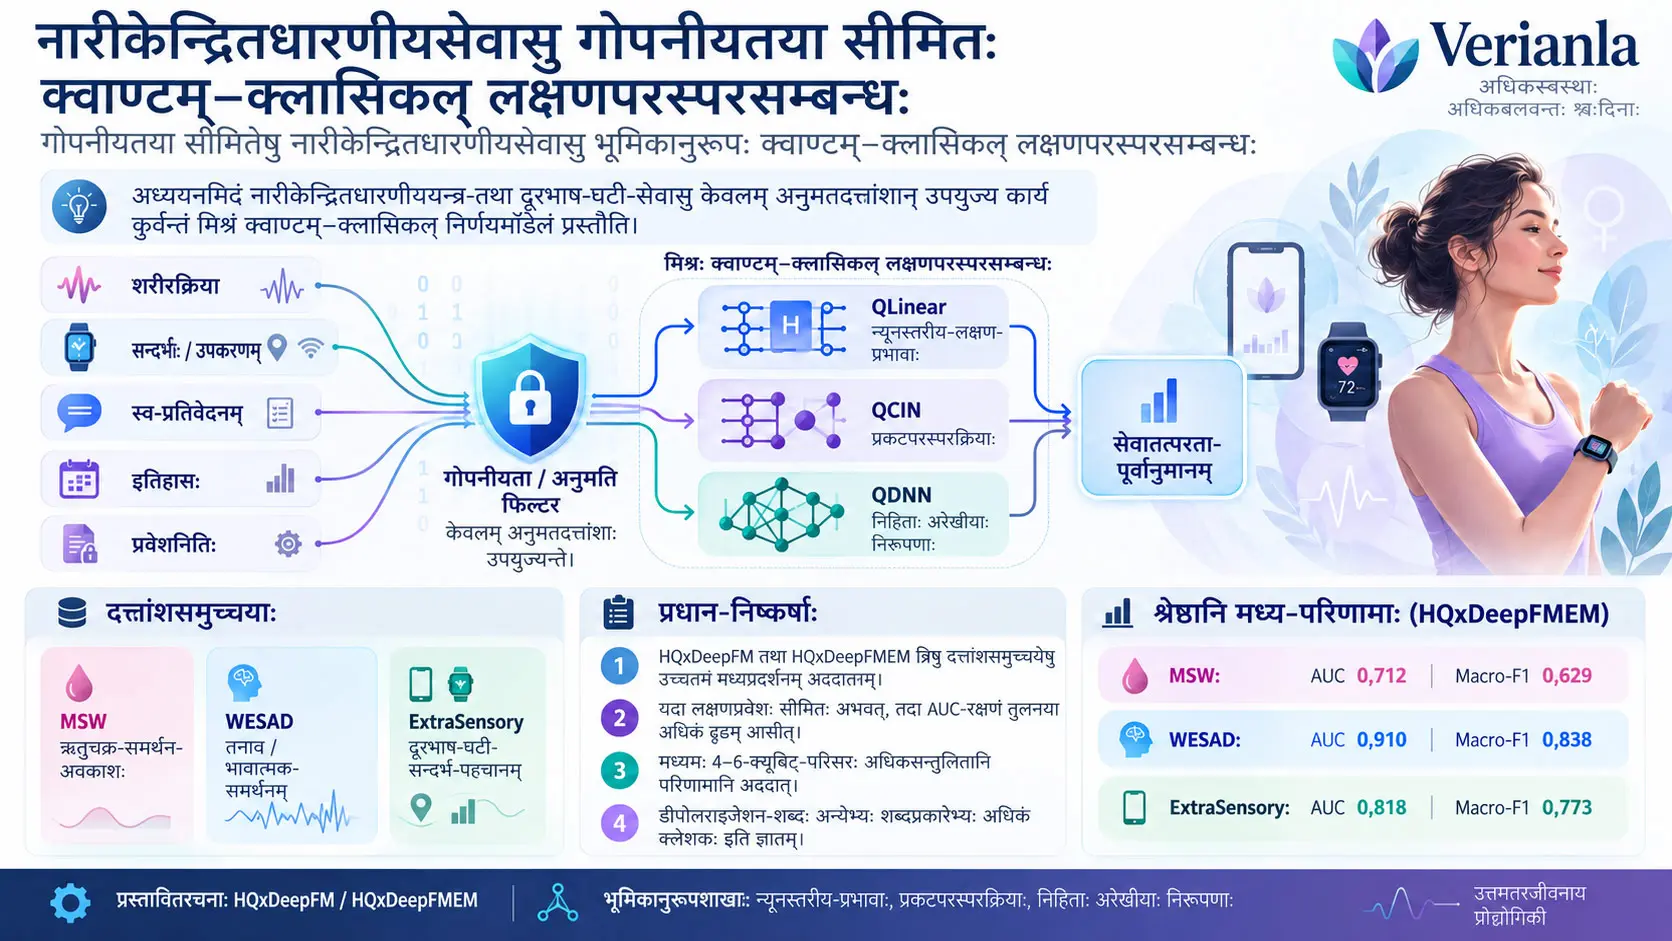
HQxDeepFM इति स्त्रीकेन्द्रितेषु धारणीययन्त्रेषु तथा दूरभाष/घटी-सेवासु अनुमताः शरीरक्रियासम्बद्धाः, सन्दर्भसम्बद्धाः, यन्त्रसम्बद्धाः, सेवेतिहाससम्बद्धाः, उपयोक्तृ-अनुमतिसम्बद्धाश्च विशेषताः सह संसाधयितुं निर्मितं privacy- तथा noise-जागरूकं hybrid quantum-classical विशेषता-परस्परक्रिया-model अस्ति। एतत् model xDeepFM-स्य निम्नस्तरीयप्रभावान्, प्रत्यक्षोच्चस्तरीयपरस्परक्रियाः, अप्रत्यक्षान् अरैखिकप्रतिनिधित्वांश्च पृथक् कार्यरूपेण यथावत् धारयति; किन्तु classical Linear, CIN तथा DNN शाखाः क्रमशः QLinear, QCIN तथा QDNN इति नामभिः अल्पगम्भीरैः Variational Quantum Circuit (VQC)-आधारितैः शाखाभिः प्रतिस्थापयति। एताः शाखाः Pauli-Z expectation values मापितविशेषता-प्रतिनिधित्वतया उत्पादयन्ति, ततः परिणामाः लघौ classical fusion-head मध्ये संयोज्यन्ते।
अध्ययनं त्रिषु मुक्तदत्तांशसमूहेषु मूल्याङ्कनं करोति: Menstrual Sleep-Wake (MSW) स्त्रीविशिष्टं smart-watch-सहायतायुक्तं मासिकचक्र-सेवावातायनकार्यं प्रतिनिधत्ते; WESAD धारणीय stress/affect-सहायतां प्रतिनिधत्ते; ExtraSensory च दूरभाष-घटी-आधारितं सन्दर्भपरिचयं प्रतिनिधत्ते। मुख्यप्रयोगाः identity leakage न्यूनयितुं MSW मध्ये प्रतिभागी-विभक्तं, WESAD मध्ये subject-विभक्तं, ExtraSensory मध्ये उपयोक्तृ-विभक्तं पञ्च-fold सत्यापनं प्रयुञ्जते। अपि च, नीति-कारणेन विशेषतासमूहानाम् अनुपयोगस्थितयः, अनुपस्थिताः sensors, शाखा-ablation, 2–8 qubit VQC-क्षमता, 2/4/6 circuit-depth, phase damping, amplitude damping तथा depolarization noise channels च परीक्ष्यन्ते।
पञ्च-fold-माध्येषु HQxDeepFMEM MSW कृते AUC 0,712 तथा Macro-F1 0,629; WESAD कृते AUC 0,910 तथा Macro-F1 0,838; ExtraSensory कृते AUC 0,818 तथा Macro-F1 0,773 परिणामान् ददाति। तस्मिन्नेव सारणौ बलवत्तराणां classical तुलनानां AUC-मूल्यानि क्रमशः 0,699, 0,898 तथा 0,806 सन्ति। अतः अध्ययनं प्रतिपादयति यत् प्रस्तावितः hybrid विन्यासः मूल्याङ्कितकार्येषु लघु किन्तु सततं माध्य-कार्यदक्षतावृद्धिं तथा अधिकानुकूलं accuracy–trainable-parameter संतुलनं ददाति। तथापि अध्ययनं preprint अस्ति; statistical significance test, वास्तविक-quantum-hardware-सत्यापनं, clinical प्रभावः, वास्तविक-उपयोक्तृस्वीकारः, अथवा device-side energy/latency-मापनं न प्रदत्तम्। अतः एते परिणामाः वास्तविकजगति स्त्रीस्वास्थ्यसेवासु प्रत्यक्ष clinical श्रेष्ठतारूपेण सामान्यीकर्तुं न युक्ताः।
अध्ययनसमस्या केवलं “उच्चतरः prediction accuracy” किमर्थं नास्ति?
धारणीयस्वास्थ्य-कल्याणसेवासु model-inputs स्थिराः न भवितुम् अर्हन्ति। उपयोक्ता केचन दत्तांशान् न दद्यात्, sensor तस्मिन् क्षणे न कार्यं कुर्यात्, application-policy कस्यचित् विशेषतायाः उपयोगं न अनुमन्येत, अथवा device-context परिवर्तेत। अतः अध्ययनस्य मुख्यसमस्या केवलं बहून् विशेषताः संयोज्य classification करणं न, अपितु केवलं अनुमतविशेषतासमूहैः कार्यं कर्तुं शक्नुवन्तं, अनुपस्थितेषु inputs तस्य व्यवहारं निरीक्षितुं शक्यं, तथा model-size तुलनया संक्षिप्तं धारयितुं शक्यं decision-layer निर्मातुम् अस्ति।
स्रोतः एतां समस्यां विशेषतः स्त्रीकेन्द्रित-सेवासन्दर्भेषु परीक्षते। मासिकचक्रसहायता इव सेवावातायनं निद्राकालः, निद्रावधिः, लय-नियमितता, basal body temperature-आधारिताः सूचकाः, cycle-timing, इच्छानुसारं self-reports, access-policy इत्यादीनां संयुक्तमूल्याङ्कनम् अपेक्षेत। तथापि model स्वास्थ्यकर्मिणः, clinical diagnosis-स्य, application-policy-स्य वा स्थानं गृह्णाति इति न उक्तम्; model नीति-स्तरानन्तरं कार्यरतः decision-support घटकः इति स्थाप्यते।
HQxDeepFM किम्, xDeepFM-तः कथं भिद्यते?
HQxDeepFM इति hybrid architecture यत् xDeepFM-स्य त्रयः मुख्यकार्यभागाः धारयति तथा प्रत्येकं पृथक् अल्पगम्भीरेण variational quantum circuit द्वारा प्रतिनिधत्ते: QLinear निम्नस्तरीयप्रभावान्, QCIN प्रत्यक्षान् cross-field interactions, QDNN अप्रत्यक्षान् अरैखिकप्रतिनिधित्वांश्च संसाधयति; त्रयाणां शाखानां Pauli-Z expectation features पश्चात् classical fusion-head मध्ये संयोज्यन्ते।
xDeepFM मध्ये Linear-शाखा एकक/निम्नस्तरीयसहभागान्, Compressed Interaction Network (CIN) प्रत्यक्षोच्चस्तरीय-feature-interactions, deep neural network (DNN) च अप्रत्यक्ष interactions प्रतिनिधत्ते। HQxDeepFM-स्य design-choice सम्पूर्णे model मध्ये एकं “quantum layer” योजयितुं न, किन्तु एतेषां त्रयाणां कार्याणां प्रत्येकस्मिन् role-aligned VQC स्थापयितुं भवति। एवं शोधकर्तारः performance परिवर्तते चेत् कस्य कार्यात्मकशाखायाः योगदानं महत्त्वतरं भवति इति ablation द्वारा पृथक् परीक्षितुं शक्नुवन्ति।
Privacy-boundary-स्य गणितीयाधारः
समीकरणम् (1) एकस्य सेवोदाहरणस्य पञ्च विशेषतासमूहान् निर्दिशति: \(x^w\) धारणीयशरीरक्रिया; \(x^c\) सन्दर्भः अथवा यन्त्रावस्था; \(x^s\) self-report अथवा symptom-क्षेत्राणि; \(x^h\) सेवेतिहासः; \(x^a\) च accessibility/policy-सूचकाः। एषा अभिव्यक्तिः performance-equation न, अपितु दत्तांशाः केषु semantic-समूहेषु विभक्ताः इति दर्शयन्ती input-definition अस्ति। चराः प्रत्यक्षभौतिक-एककयुक्तानि एकक-मापनानि एव भवेयुः इति न; प्रत्येकः समूहः अनेकाः scaled अथवा embedded विशेषताः धारयितुं शक्नोति।
समीकरणे (2) \(g\) विशेषतासमूहस्तरीयः द्विमूल्य accessibility-vector अस्ति। कस्यचित् समूहस्य \(g=1\) चेत् सः समूहः model प्रति प्रेष्यते; \(g=0\) चेत् उपयोक्तृचयनात्, application-policy-तः अथवा sensor-अभावात् सम्बन्धितः समूहः mask क्रियते। गणिततः एतत् समूहस्य model-input प्रति योगदानं शून्यं करोति। वैज्ञानिकार्थः—“privacy” इति केवलं अमूर्त-नैतिक-संज्ञा न भवति, किन्तु प्रयोगे नियन्त्रितः feature-access-condition भवति। किन्तु एषः mask वास्तविक-उपयोक्तृसम्मतेः सामाजिकं वा विधिकं वा समग्रत्वं model न करोति; अध्ययने प्रयोगशर्तरूपेण प्रयुज्यते।
समीकरणम् (3), masked input \(\tilde{x}\) तथा learnable parameters \(\Theta\) दत्ते लक्ष्यवर्गस्य सम्भावनां निर्दिशति। \(y\) “support-window” अथवा “service-readiness” label; \(\hat{y}\) च model prediction अस्ति। एषा सम्भावना clinical-risk-probability इति न व्याख्येया; सा दत्तांशसमूहे परिभाषितस्य classification-target-स्य model-output अस्ति।
Privacy Boundary Model-Inputs मध्ये कथं प्रयुज्यते?
अध्ययने privacy-boundary विशेषतान् पश्चात् एकैकशः लोपयितुं न, अपितु physiology, context/device, self-report, service-history तथा access-policy इति समूहेषु विभज्य group-level binary permission-vector द्वारा masking कृत्वा प्रयुज्यते; अतः अनुपलब्धसमूहस्य स्थाने model शेषेभ्यः अनुमतसमूहेभ्यः interactions शिक्षितुं बाध्यते।
एषः उपायः “missing sensor” प्रयोगमपि एकस्मिन् सामान्ये framework मध्ये परीक्षितुं शक्नोति। शोधकर्तारः full-feature-condition तथा केषाञ्चित् समूहानां क्रमशः धारणयुक्ताः conditions तुलयन्ति, AUC कियत् रक्षितम् इति मापयन्ति। एवं model केवलं high full-data performance द्वारा न, अपितु data-access सीमिते सति तस्य relative robustness द्वारा अपि मूल्याङ्क्यते।
Variational quantum circuit-शाखा कथं features उत्पादयति?
समीकरणम् (4) दर्शयति यत् प्रत्येकस्य \(q\)-शाखायां classical input-vector \(v_q\) प्रथमं data encoder \(U_{enc}\) द्वारा quantum-state मध्ये encode क्रियते, ततः learnable parameters \(\theta_q\) युक्तेन variational block \(U_q\) द्वारा परिवर्त्यते। \(n_q\) शाखायाः qubit-width अस्ति। Circuit-output प्रत्यक्षं class-label न; प्रत्येकस्य qubit कृते Pauli-Z observable-स्य expectation value \(\langle Z_i\rangle\) माप्यते, तानि च \(e_q\) feature-vector निर्मान्ति। Pauli-Z expectation आयामरहितः तथा आदर्शे −1 तः +1 पर्यन्तं quantum-observable-स्य माध्यं प्रतिनिधत्ते।
स्रोतः प्रत्येकस्य शाखायां angle encoding तथा पुनरावृत्त rotation–entanglement blocks प्रयुक्ताः इति वदति। “Circuit depth” अत्र एतेषां trainable blocks-स्य पुनरावृत्तिसंख्या। sensitivity-analysis मध्ये branch-width 2, 4, 6 तथा 8 qubit; circuit-depth 2, 4 तथा 6 इति परीक्षितम्। अध्ययनं कस्यचित् physical quantum device-स्य नाम, real hardware backend अथवा hardware shot-count न निर्दिशति; अतः एते परिणामाः वास्तविक quantum-hardware-performance इति न ग्रहीतव्याः।
त्रयाणां quantum-शाखानां outputs कथं संयोज्यन्ते?
समीकरणे (5), \(e_{QL}\), \(e_{QCIN}\), \(e_{QDNN}\) च त्रयाणां quantum-शाखानां measured features सन्ति। कोष्ठकाः concatenation, \(h(\cdot)\) लघु classical fusion-head, \(\sigma\) च sigmoid transformation दर्शयन्ति। एवं quantum circuits मध्यवर्ती feature-producers रूपेण, classical head अंतिम probability-predictor रूपेण कार्यं करोति। एषा hybrid-विभागना अध्ययनं “quantum model सम्पूर्णं classification स्वयमेव करोति” इति न वदति इति स्पष्टयति।
QCIN प्रत्यक्ष interactions कथं धारयति?
समीकरणम् (6) xDeepFM/CIN-कुलस्य प्रत्यक्ष cross-interaction-तर्कं धारयन्तं compressed-interaction-step दर्शयति। \(x^{0}_{j,*}\) मूल field-embedding, \(x^{k-1}_{i,*}\) पूर्व-interaction-layer-स्थितिः, \(W^{k,h}_{ij}\) learnable coefficient, \(\odot\) च Hadamard अर्थात् element-wise multiplication दर्शयति। \(m\) मूलक्षेत्राणां संख्यां, \(H_{k-1}\) पूर्वस्तरस्य interaction-maps-संख्यां प्रतिनिधत्ते। गणितीयकार्यं field-pairs-स्य element-wise products शिक्षणीयभारैः संयोज्य प्रत्यक्षोच्चस्तरीय interactions निर्मातुम् अस्ति। HQxDeepFM मध्ये एतानि cross-features पश्चात् VQC compression-unit द्वारा Pauli-Z expectation-features मध्ये परिवर्त्यन्ते।
Training loss किं optimizes करोति?
समीकरणम् (7) binary cross-entropy तथा L2 regularization संयोजयति। प्रथमः पदः वास्तविक label \(y_i\) तथा prediction \(\hat{y}_i\) मध्ये classification-error दण्डयति; द्वितीयः पदः model-parameters \(\Theta\)-स्य परिमाणं \(\lambda\)-गुणकेन सीमितं करोति। \(N\) mini-batch अथवा computation-group मध्ये samples-संख्यां दर्शयति। उद्देश्यं केवलं training-data प्रति अतिअनुकूलनं न, अपितु संतुलित parameter-magnitudes सह सामान्य-performance रक्षितुम् अस्ति। स्रोतः एतत् समीकरणं ददाति; किन्तु optimizer-type, learning-rate, batch-size, epoch-count इत्यादीनि training-details स्पष्टतया न ददाति।
Feature-access न्यूनतायां performance कथं माप्यते?
समीकरणम् (8) full-feature AUC तथा access-mask-अधीन AUC मध्ये absolute loss मापयति। मूल्यं यावत् वर्धते, तावत् feature-group धारणेन model-discrimination अधिकं न्यूनम्। समीकरणम् (9) तमेव परिवर्तनं प्रतिशततः AUC retention रूपेण ददाति। Full-feature performance %100 इति स्वीक्रियते; उदाहरणतः %90 \(R_{AUC}\) इत्यस्य अर्थः masked-condition मध्ये full-feature AUC-स्य %90 भागः रक्षितः। एषः अनुपातः विभिन्नेषु datasets प्रारम्भिक-AUC भिन्नेषु अपि relative robustness तुलनां सुलभां करोति।
HQxDeepFMEM Quantum Noise कथं न्यूनयति?
HQxDeepFMEM स्वच्छ-model-स्य quantum-शाखाः प्रशिक्षणानन्तरं freeze करोति; केवलं training-fold मध्ये निर्मितान् clean तथा folded-noisy expectation profiles उपयुज्य MLP zero-noise extrapolation model शिक्षते, validation-fold मध्ये noisy Pauli-Z expectations अनुमानित-zero-noise-मूल्यैः प्रतिस्थाप्य तेनैव classical fusion-head द्वारा पुनः prediction निर्माति।
समीकरणम् (10) quantum-noise-ं completely positive trace-preserving (CPTP) channel रूपेण प्रतिनिधत्ते। \(\rho\) input density matrix, \(\rho'\) noise-पश्चात् अवस्था, \(\mathcal{E}\) channel, \(A_i\) Kraus operators च। अध्ययनं phase damping, amplitude damping तथा depolarization channels एतस्मिन् framework मध्ये नियन्त्रित-विघातक-प्रक्रियारूपेण प्रयुज्यते। एतत् समीकरणं स्वयमेव noise “सुधारयति” इति न; केवलं भौतिकतया वैधस्य noise-transformation-स्य गणितीयप्रतिनिधित्वम् अस्ति।
Error-mitigation-चरणे MLP-ZNE regressor \(f_{\phi}\) विभिन्न-noise-scales मध्ये प्राप्तेभ्यः folded expectations स्वच्छ-expectation-reference अनुमानयितुं शिक्षते। Training-pairs केवलं training-fold तः निर्मीयन्ते; validation-labels अथवा downstream-targets अस्य regressor-स्य प्रशिक्षणाय न प्रयुज्यन्ते। एषा विभागना error-mitigation-चरणे validation-information leakage निवारयितुं प्रयतते। Noise-पश्चात् performance \(100\times AUC_{mitigated}(p)/AUC_{clean}\) इति retention-ratio द्वारा निवेद्यते।
Noise channels समानां कठिनतां जनयन्ति वा?
न। अध्ययनस्य heat-maps दर्शयन्ति यत् न्यून-मध्यम-noise-levels मध्ये phase damping तथा amplitude damping-अधीन MLP-ZNE पश्चात् उच्च-AUC-retention दृश्यते; depolarization-noise तु अधिकं performance-loss जनयति। Noise-probability \(p\) कृते 0,01, 0,03, 0,05, 0,10 तथा 0,15 स्तराः; qubit-count कृते 2, 4, 6 तथा 8 स्तम्भाः परीक्षिताः। लेखकानां व्याख्या अस्ति यत् depolarization signal-bearing Pauli-Z expectations अधिकव्यापकतया विकृतं करोति तथा MLP-आधारित extrapolation कृते न्यून-संरचितं error-pattern अवशिष्यते।
एते परिणामाः वास्तविकं quantum advantage दर्शयन्ति वा?
अध्ययनं “quantum advantage” अथवा classical computation-स्य अगम्यं computational advantage न दर्शयति। तुलना निर्दिष्ट-hybrid-architecture-स्य classification-metrics, trainable-parameter-load, feature-access-robustness तथा controlled-noise-अधीन AUC-retention विषये अस्ति। वास्तविक quantum-hardware latency, shot-cost, quantum-processing-time, error-calibration अथवा energy-consumption न निवेदितम्; अतः परिणामाः algorithm/model-level experiments रूपेण मूल्याङ्कनीयाः।
अध्ययनस्य विधिः परिणामाश्च
दत्तांशसमूहाः कार्याणि च
| दत्तांशसमूहः | सेवाकार्यम् / primitive | मुख्यविशेषतासमूहाः | सत्यापनम् | Metrics |
|---|---|---|---|---|
| MSW | Smart-watch-सहायतायुक्त-मासिकचक्रस्य support-window-prediction | निद्रामध्यबिन्दुः, निद्रावधिः, लय-नियमितता, BBT-derived सूचकाः, cycle-timing, इच्छानुसारं self-reports तथा access-masks | प्रतिभागी-विभक्तं 5 fold | AUC, Macro-F1 |
| WESAD | भावात्मक-कल्याणाय धारणीय stress-support-prediction | EDA, BVP, त्वक्-तापमानम्, accelerometer, श्वसनसम्बद्धसंकेताः तथा device-availability-masks | Subject-विभक्तं 5 fold | AUC, Macro-F1 |
| ExtraSensory | Context-aware safety/service adaptation कृते phone-watch-context-recognition | Phone/watch-motion-features, temporal-context, device-status, sensor-availability तथा policy-masks | उपयोक्तृ-विभक्तं 5 fold | AUC, Macro-F1 |
Labels model-training पूर्वं मुक्तदत्तांशसमूहानां विद्यमानविवरणेभ्यः अथवा fields तः निर्मीयन्ते। MSW अध्ययनस्य स्त्रीविशिष्टः मुख्याधारः। WESAD तथा ExtraSensory प्रत्यक्षं स्त्रीविशिष्ट-datasets इति न प्रस्तुतौ; भावात्मक-कल्याण तथा context-recognition इत्यादीनां transferable service-components परीक्षणाय प्रयुज्येते। एषा विभागना “त्रिषु सर्वेषु datasets स्त्रीविशिष्ट clinical validation कृतम्” इति मिथ्या-सामान्यीकरणं निवारयति।
तुलनात्मक-models
अध्ययनं Logistic Regression (LR), Random Forest (RF), LightGBM, DeepFM, xDeepFM तथा AutoInt इत्येतान् तुलना-आधाररूपेण प्रयुञ्जते। एषः समूहः linear decision-boundary तः tree-ensembles पर्यन्तं, प्रत्यक्षोच्चस्तरीय interactions तः deep तथा attention-based representations पर्यन्तं विभिन्न-classical-model-families आच्छादयति। HQxDeepFM तथा HQxDeepFMEM, xDeepFM-समान embedding-dimension तथा branch-skeleton उपयुञ्जाताम् इति विन्यस्तौ; अतः लेखकाः performance-difference केवलं बृहत्तर-input-representation कारणं न मन्यन्ते।
मुख्य-performance-results
| Model | MSW | WESAD | ExtraSensory | |||
|---|---|---|---|---|---|---|
| AUC | Macro-F1 | AUC | Macro-F1 | AUC | Macro-F1 | |
| LR | 0,632 ± 0,009 | 0,551 ± 0,009 | 0,818 ± 0,006 | 0,734 ± 0,005 | 0,737 ± 0,008 | 0,686 ± 0,007 |
| RF | 0,659 ± 0,013 | 0,575 ± 0,013 | 0,854 ± 0,009 | 0,773 ± 0,006 | 0,764 ± 0,009 | 0,714 ± 0,008 |
| LightGBM | 0,688 ± 0,012 | 0,597 ± 0,016 | 0,887 ± 0,004 | 0,801 ± 0,004 | 0,792 ± 0,011 | 0,738 ± 0,011 |
| DeepFM | 0,674 ± 0,012 | 0,589 ± 0,011 | 0,877 ± 0,007 | 0,792 ± 0,008 | 0,790 ± 0,008 | 0,735 ± 0,007 |
| xDeepFM | 0,697 ± 0,011 | 0,615 ± 0,010 | 0,885 ± 0,006 | 0,807 ± 0,006 | 0,801 ± 0,009 | 0,752 ± 0,008 |
| AutoInt | 0,699 ± 0,017 | 0,610 ± 0,013 | 0,898 ± 0,005 | 0,821 ± 0,004 | 0,806 ± 0,008 | 0,756 ± 0,008 |
| HQxDeepFM | 0,710 ± 0,015 | 0,626 ± 0,012 | 0,908 ± 0,006 | 0,836 ± 0,004 | 0,815 ± 0,009 | 0,769 ± 0,009 |
| HQxDeepFMEM | 0,712 ± 0,011 | 0,629 ± 0,011 | 0,910 ± 0,005 | 0,838 ± 0,006 | 0,818 ± 0,007 | 0,773 ± 0,004 |
सारणौ सर्वोच्चानि माध्य-AUC तथा Macro-F1 मूल्यानि त्रिषु datasets अपि HQxDeepFMEM-पङ्क्तौ सन्ति। Verianla द्वारा केवलं सारणीमूल्येभ्यः कृतसाधारण-अन्तरगणनायां HQxDeepFMEM-स्य AUC, प्रत्येकस्य dataset-स्य सर्वोच्च-classical-AUC अपेक्षया MSW मध्ये +0,013, WESAD मध्ये +0,012, ExtraSensory मध्ये +0,012 उच्चतरम्। Macro-F1 कृते त एव absolute differences क्रमशः +0,014, +0,017 तथा +0,017 सन्ति। एते न नूतन-experimental-results, न statistical effect sizes; स्रोतसारणेः माध्य-मूल्यानां arithmetic differences एव। लेखः p-value, confidence interval अथवा paired significance test न निवेदयति; अतः एते भेदाः “statistically proven superiority” इति न व्याख्येयाः।
Accuracy–compactness संतुलनम्
स्रोतस्य accuracy–compactness graph दर्शयति यत् HQxDeepFM-family classical deep-interaction-models अपेक्षया उच्चतरं AUC न्यूनतर-trainable prediction-engine parameter-load सह संयोजयन्तं क्षेत्रं प्रति गच्छति। Parameter-count मध्ये embedding/projection-components, trainable VQC-angles तथा classical fusion-head अन्तर्भवन्ति; HQxDeepFMEM कृते MLP-ZNE-regressor अपि गणितः। Preprocessing तथा noise-channel-operators trainable-parameter-count मध्ये न अन्तर्भवन्ति। स्रोतgraph अनुमानित-parameter-positions दर्शयति, किन्तु text मध्ये model-wise exact parameter-table नास्ति; अतः अत्र नूतन-exact-parameter-numbers न निर्मिताः।
Branch ablation किं दर्शयति?
समान-data-splits अधीन ablation मध्ये QDNN निष्कासिते सर्वोच्च-performance-drop दृश्यते। एतत् निष्कर्षं सूचयति यत् अप्रत्यक्ष अरैखिकrepresentation धारणीय तथा phone/watch-data मध्ये discriminative-patterns कृते बलवत्तरशाखासु एका भवेत्। QCIN निष्कासिते अपि performance स्पष्टतया दुर्बलम्; एतत् physiology, context, service-history तथा access-masks मध्ये प्रत्यक्ष cross-interactions-स्य योगदानं समर्थयति। QLinear निष्कासिते पतनं मन्दतरं किन्तु सततम्; लेखकाः एतत् निम्नस्तरीयप्रभावाः प्रधानाः न सन्तः अपि स्थिरम् आधारं निर्मान्ति इति व्याख्यायन्ति।
Feature-access तथा missing-sensor robustness
अध्ययनस्य feature-access प्रयोगे अनुमत-feature-groups-स्य क्रमशः बृहत्तरः भागः ध्रियते, full-feature-condition अपेक्षया AUC-retention निरीक्ष्यते। Graphs दर्शयन्ति यत् 0 तः %40 पर्यन्तं वर्धमान retained-feature-group अनुपातेषु सर्वेषां models-स्य performance न्यूनं भवति, HQxDeepFM तु मूल्याङ्कित-classical-interaction-models अपेक्षया उच्चतर-relative-AUC-retention प्रवृत्तिं दर्शयति। एतत् परिणामं सूचयति यत् model एकस्मिन् privacy-sensitive-flow मध्ये पूर्णतया आश्रितं न; किन्तु वास्तविक-user-consent-behavior अथवा वास्तविक-sensor-failure-स्य field-test न।
Qubit-संख्या तथा circuit-depth
Capacity-scan प्रत्येकस्य VQC-शाखायां 2, 4, 6 तथा 8 qubit; 2, 4 तथा 6 पुनरावृत्त trainable circuit-depth तुलयति। Curve-behavior monotonic न: 2 qubit तः मध्यम-width प्रति गमनं बहुषु कार्येषु AUC वर्धयति, 8 qubit मध्ये लाभः saturation प्राप्नुयात् अथवा न्यूनः भवेत्। Discussion-section मूल्याङ्कितकार्येषु 4–6 qubit-परिसरं accuracy तथा resource/noise-load मध्ये अधिकसंतुलितं operating-region इति व्याख्यायति। एतत् सर्वेषु VQC-applications कृते universal best qubit-count न; केवलं एतेषु कार्येषु अस्मिन् experimental-protocol मध्ये दृष्टा प्रवृत्तिः।
Noise-पश्चात् AUC-retention
HQxDeepFMEM-स्य MLP-ZNE-चरणं phase damping तथा amplitude damping-अधीन न्यून-मध्यम-noise-levels मध्ये उच्च-AUC-retention ददाति। Heat-maps मध्ये depolarization-noise विशेषतः उच्च-\(p\)-मूल्येषु तीव्रतरं पतनं जनयति। उदाहरणतः स्रोत-heat-map मध्ये \(p=0,15\) पङ्क्तौ depolarization-अधीन retention-values dataset तथा qubit-count अनुसारं लगभग 80-range-स्य निम्नभागात् 80-range-स्य उच्चभागपर्यन्तं न्यूनानि भवितुम् अर्हन्ति; एतानि मूल्यानि figure तः पठितानि, अत्र exact common coefficient रूपेण सामान्यीकर्तुं न युक्तम्। मुख्यवैज्ञानिकसन्देशः—error mitigation noise पूर्णतया न नाशयति, depolarization च सर्वाधिक-कठिन-channel एव तिष्ठति।
अध्ययनेन समर्थिताः निष्कर्षाः
- Role-aligned QLinear, QCIN तथा QDNN शाखाः संयोजयन् HQxDeepFM त्रिषु मूल्याङ्कितकार्येषु classical तुलनाभ्यः उच्चतरं माध्य-AUC तथा Macro-F1 दत्तवान्।
- HQxDeepFMEM, MLP-सहायित zero-noise extrapolation पश्चात् HQxDeepFM अपेक्षया लघून् अतिरिक्तान् माध्यलाभान् दर्शितवान्।
- प्रतिभागी/subject/उपयोक्तृ-विभक्तः पञ्च-fold design, एकस्यैव व्यक्तेः training तथा validation पक्षयोः उपस्थित्या सम्भावितं identity-dependent leakage न्यूनयितुं प्रयतते।
- Feature-access-masks अधीन relative AUC-retention, अनुमत-information-groups न्यूनाः भवन्ति चेत् model कथं degrade भवति इति मापनाय प्रयुज्यते।
- Branch-ablation QDNN-स्य महत्तमं, QCIN-स्य महत्त्वपूर्णं, QLinear-स्य मन्दतरं किन्तु सततं योगदानं दर्शयति।
- Qubit-width-वृद्धिः स्वयमेव श्रेष्ठफलम् न दत्तवती; मूल्याङ्कितकार्येषु मध्यमः 4–6 qubit-परिसरः अधिकसंतुलितः अभवत्।
- Depolarization-noise phase तथा amplitude damping अपेक्षया error-mitigation कृते कठिनतरः अभवत्।
अध्ययनेन न समर्थितानि सामान्यीकरणानि
- एते परिणामाः HQxDeepFM clinical-रूपेण स्त्रीस्वास्थ्य-निदानं कर्तुं वा स्वास्थ्यफलम् उन्नतयितुं शक्नोति इति न दर्शयन्ति।
- WESAD तथा ExtraSensory-परिणामाः स्त्रीविशिष्ट clinical validation न; ते transferable stress तथा context-recognition कार्याणि।
- Policy-defined feature-masks वास्तविक-उपयोक्तृणां विधिक-consent-processes, privacy-perception अथवा दीर्घकालीनव्यवहारं सत्यापयन्ति न।
- अध्ययनं physical quantum hardware मध्ये speed, energy, error-rate अथवा cost-advantage न दर्शयति।
- माध्य AUC/Macro-F1 differences statistical significance test न निवेदितः इति universal superiority proof न।
- 4–6 qubit observation अन्येषु datasets, deeper-circuits अथवा different quantum-hardware कृते universal optimum न स्वीकरणीयम्।
Reproducibility-दृष्ट्या अनुपस्थितविवरणानि
स्रोतः architecture-equations, separated-fold-protocol, comparison-models, qubit/depth-scan, noise-channels तथा मुख्यmetrics वर्णयति। किन्तु PDF-स्य method तथा experiment विभागेषु optimizer-type, learning-rate, mini-batch-size, epoch-count, early-stopping-setting, random-seeds, quantum-measurement-shot-count, प्रयुक्त software/quantum-simulator अथवा physical-hardware-backend, MLP-ZNE-layer-sizes तथा noise-scaling-coefficients-स्य concrete-values स्पष्टतया न निवेदिताः। एते अभावाः source-code अथवा supplementary-material विना प्रयोगस्य exact reproduction सीमितं कुर्वन्ति।
Application-दृष्ट्या एतस्य अर्थः कः?
अध्ययनस्य बलवत्तरः application-idea “स्त्रीस्वास्थ्याय quantum AI” इति व्यापक-स्लोगन न; अपितु अनुमत-दत्तांशसमूहानुसारं कार्यं कर्तुं शक्नुवन्तं तथा कस्य functional-interaction-branch-स्य कियत् योगदानम् इति परीक्षितुं शक्यं compact decision-layer इति विचारः। एतादृशं layer भविष्ये मासिकचक्रसहायता, stress/well-being notifications अथवा context-aware safety-alerts इत्यादीनां सेवापूर्वं प्रयुज्येत। किन्तु वास्तविक-application कृते user-studies, ethically-approved prospective evaluation, privacy-comfort, false-alert-cost, latency, energy-consumption, hardware-reliability तथा regulatory-compliance पृथक् सत्यापनीयानि।
स्रोत-विधि-सम्बद्धा टिप्पणी
मूल-अध्ययनम्: Role-Aligned Quantum–Classical Feature Interaction for Privacy-Bounded Women-Centric Wearable Services.
लेखकाः: Wenbin Yu; Yanfeng Fan; Youle Wang; Hanmiao Cheng; Ran Li; Konglin Zhu; Yadang Chen.
Corresponding author: Hanmiao Cheng. PDF मध्ये उत्तरदायी लेखकः तारकचिह्नेन निर्दिष्टः।
समानयोगदानम्: स्रोत-PDF मध्ये equal contribution/co-first-author घोषणा न लब्धा।
Affiliations: School of Software, Nanjing University of Information Science and Technology; School of Computer Science, Nanjing University of Information Science and Technology; Jiangsu Collaborative Innovation Center of Atmospheric Environment and Equipment Technology, Nanjing University of Information Science and Technology; Wuxi Institute of Technology, Nanjing University of Information Science and Technology; Nanjing Quantum AI Technology Co., Ltd.; Nanjing Boswell Industrial Communication Technology Co., Ltd.; Marketing Service Center, State Grid Jiangsu Electric Power Co., Ltd.; Department of Electrical and Computer Engineering, Michigan State University.
स्रोतप्रकारः: Preprint research paper.
Peer-review-स्थितिः: PDF स्पष्टतया वदति यत् अध्ययनं peer review न अतीतम्।
Platform: SSRN, abstract 7477255.
प्रकाशनदिनाङ्कः: SSRN record-page मध्ये 17 सितम्बर 2026 इति published/posted दृश्यते।
DOI: 10.2139/ssrn.7477255.
Journal: स्रोतः journal article रूपेण प्रकाशितं संस्करणं न; एषा सञ्चिका SSRN preprint-version अस्ति।
License: PDF तथा सत्यापित-SSRN-bibliographic-record मध्ये लेखस्य पुनरुपयोगं स्पष्टतया अनुमन्यमानं Creative Commons license न लब्धम्। अतः Verianla मध्ये स्रोतfigures-स्य screenshot अथवा style-copy न प्रयुक्ता; method-relations स्वातन्त्र्येण निर्मित-SVG-scheme द्वारा पुनरभिव्यक्ताः तथा numerical-results मूल-HTML-table-layout मध्ये प्रस्तुताः।
Bibliographic-record-अन्तरम्: Uploaded PDF लेखकं Konglin Zhu इति दर्शयति तथा Ran Li-ं Nanjing University of Information Science and Technology सम्बद्धेषु a/b/c affiliations अधः स्थापयति। SSRN-स्य वर्तमानं web meta record तु Zhu-नाम Konlin Zhu इति तथा Ran Li affiliation East China Normal University इति दर्शयति। अस्मिन् Verianla-पाठे researcher-identity कृते uploaded-PDF-स्य spelling तथा affiliation आधाररूपेण गृहीते, अन्तरं न गुप्तम्।
Funding / conflict of interest / data availability / CRediT: Uploaded PDF मध्ये पृथक् स्पष्टं funding, conflict-of-interest, data-availability अथवा CRediT author-contribution statement न लब्धम्। प्रयोगाः MSW, WESAD तथा ExtraSensory इति मुक्तदत्तांशसमूहान् आधृताः इति स्रोतः वदति; एषा सूचना पृथक् data-availability statement-स्य स्थानं न गृह्णीयात्।
मुख्यविधिसीमा: अध्ययनं सार्वजनिक-मुक्तदत्तांशसमूहेषु तथा नियन्त्रित-experimental-access/noise-conditions मध्ये model-evaluation अस्ति। Prospective clinical study, वास्तविक-user-intervention, वास्तविक-device-deployment अथवा physical quantum-hardware-test न।
Leave a comment
Your email address will not be published. Required fields are marked *