


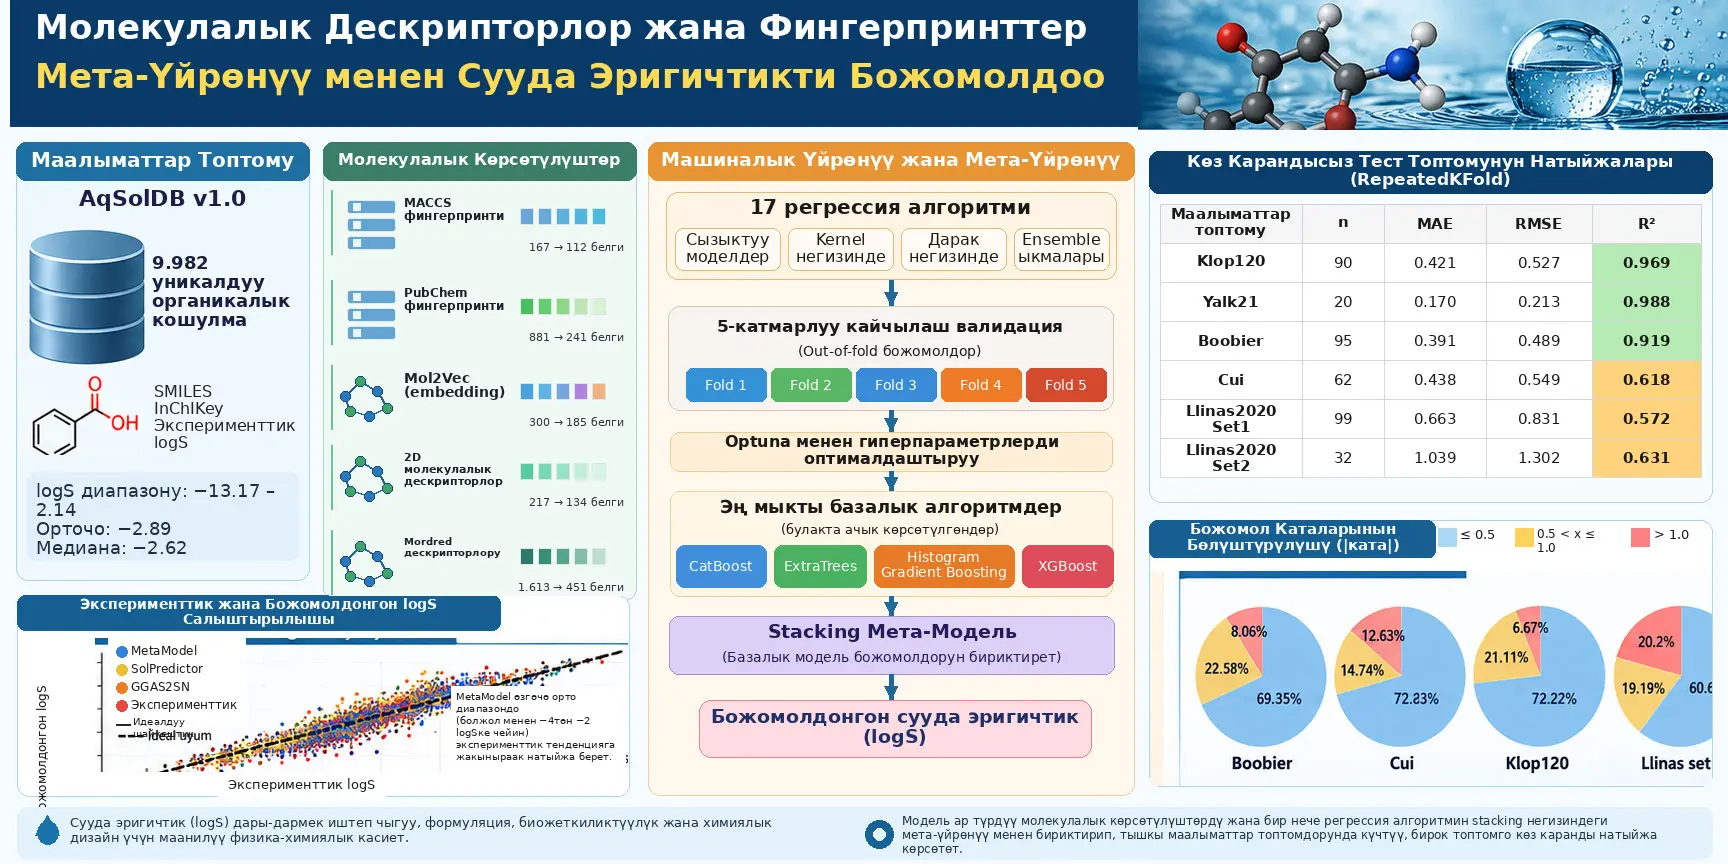
Бул изилдөөдөгү stacking негизиндеги мета-модель молекуланы бир нече сандык көрсөтүлүш менен коддоп, ар түрдүү регрессия алгоритмдеринин божомолдорун жогорку деңгээлдеги үйрөнүү катмарында бириктирүү аркылуу сууда эригичтикти (logS) божомолдогон машиналык үйрөнүү системасы болуп саналат. Изилдөөчүлөр AqSolDB v1.0 базасынан алдын ала иштетүүдөн кийин калган 9.982 уникалдуу органикалык кошулманы колдонушкан; MACCS фингерпринттери, PubChem фингерпринттери, Mol2Vec embedding-дери, эки өлчөмдүү молекулалык дескрипторлор жана Mordred дескрипторлору сыяктуу бири-бирин толуктоочу молекулалык көрсөтүлүштөрдү баалашкан. Жалпысынан 17 регрессия алгоритми беш катмарлуу кайчылаш валидация менен салыштырылып, гиперпараметрлер Optuna аркылуу оптималдаштырылган жана эң ийгиликтүү конфигурациялар stacking архитектурасында бириктирилген.
Моделдин натыйжалуулугу окутуунун ичиндеги кайчылаш валидация менен гана бааланган эмес; Klop120, Yalk21, Boobier, Cui жана эки Llinas2020 топтому сыяктуу көз карандысыз тышкы тест топтомдорунда да сыналган. Table 2-де RepeatedKFold негизиндеги MetaModel; Klop120-де R²=0.969 жана RMSE=0.527, Yalk21-де R²=0.988 жана RMSE=0.213, Boobier-де R²=0.919 жана RMSE=0.489 көрсөткүчтөрүнө жеткен. Бирок Cui жана өзгөчө Llinas маалыматтар топтомдорунда натыйжалуулук төмөндөйт; мисалы, Llinas2020 Set1 үчүн RepeatedKFold R²=0.572, Set2 үчүн R²=0.631. Бул жагдай моделдин ийгилиги химиялык бөлүштүрүүгө жана окутуу мейкиндиги менен тышкы тест мейкиндигинин окшоштугуна көз каранды экенин көрсөтөт.
Булак ошондой эле моделди SolPredictor жана GGAS2SN аттуу мурдагы ыкмалар менен салыштырууну сунуштайт. MetaModel Table 3-те Boobier, Klop120, Llinas set1, Lovric1 жана Yalk21 маалыматтар топтомдорунда жалпысынан төмөнүрөөк ката жана/же жогорураак R² көрсөтөт. Бирок ар бир маалыматтар топтомунда биринчи эмес: Cui жана Llinas set2-де GGAS2SN айрым негизги ката жана R² метрикалары боюнча MetaModel-ден жакшыраак көрсөткүчтөрдү берет. Ошондуктан изилдөө “MetaModel бардык химиялык мейкиндиктерде бардык атаандаштарды жеңет” деген жыйынтыкты колдобойт.
Изилдөөнүн күчтүү жактарынын бири — маалыматтын агып кетишин азайтууга багытталган баалоо түзүлүшү. Алдын ала иштетүү маалыматтар бөлүнгөндөн кийин ар бир окутуу fold-унун ичинде өз алдынча жүргүзүлгөн, ал эми GroupKFold тажрыйбасында Bemis–Murcko scaffold-дору колдонулуп, бир эле негизги молекулалык скелетке ээ кошулмалардын окутуу жана валидация fold-доруна таралышынын алдын алынган. Ошого карабастан, негизги PDF exact random seed, Optuna trial саны жана издөө мейкиндиги, meta-learner-дин так алгоритми жана эсептөө жабдуулары сыяктуу кайра өндүрүмдүүлүк үчүн пайдалуу айрым деталдарды билдирбейт.
Изилдөөнү чечмелөөдөгү эң маанилүү чектөө мындай: жогорку R² жана төмөн RMSE маанилери модель эксперименттик эригичтик өлчөөсүн бардык химиялык класстарда катасыз алмаштырат дегенди билдирбейт. Булактын Figure 1 сүрөтүндө өтө төмөн же өтө жогорку эригичтикке ээ кошулмаларда божомолдордун тегизделүү тенденциясы бар экени, Llinas маалыматтар топтомдорунда каталар көбөйгөнү жана моделдин натыйжалуулугу маалыматтардын бөлүштүрүлүшүнө көз каранды экени ачык көрүнөт. Модель молекулаларды эрте этапта скринингдөө үчүн эсептөөчү курал; эксперименттик эригичтик өлчөөсүнүн универсалдуу ордуна жүрүүчү каражат эмес.
Изилдөө маселеси эмне үчүн маанилүү?
Сууда эригичтик — молекуланын сууну камтыган чөйрөдө канчалык деңгээлде эриши мүмкүн экенин билдирген негизги физика-химиялык касиет. Дары-дармек иштеп чыгууда эригичтик формуляциялоого мүмкүнчүлүктү, биожеткиликтүүлүктү жана фармакокинетикалык жүрүм-турумду таасирлентет. Булак бул эле маселе agrochemical иштеп чыгууда жана материалдарды изилдөөдө да маанилүү экенин белгилейт. Эксперименттик эригичтик өлчөөлөрү баалуу болгону менен убакытты, ресурстарды жана лабораториялык шарттарды талап кылат; ошондой эле pH, температура жана кристалл формасы сыяктуу эксперименттик факторлорго сезгич болушу мүмкүн.
Ошондуктан изилдөө маселеси “машиналык үйрөнүү модели logSти божомолдой алабы?” деген суроо менен эле чектелбейт. Негизги суроо — бири-биринен айырмаланган химиялык маалымат түрлөрүн көрсөткөн молекулалык дескрипторлорду, binary fingerprint-терди жана үйрөнүлгөн embedding-дерди бир нече регрессия модели менен бириктирүүнүн натыйжасында тышкы химиялык маалыматтар топтомдоруна туруктуураак эригичтикти божомолдоо системасын түзүүгө болобу деген маселе.
Сууда Эригичтикти Божомолдоодо logS Эмнени Билдирет?
Бул макалада logS — эксперименттик сууда эригичтиктин логарифмдик максаттуу өзгөрмөсү; модель божомолдоого аракет кылган үзгүлтүксүз сандык чыгыш ушул. AqSolDB негизиндеги окутуу маалыматтарында logS маанилери −13.17 менен 2.14 аралыгында өзгөрөт жана булак төмөн маанилерди өтө төмөн эригичтикке, жогорку маанилерди жогорураак эригичтикке туура келген шкала катары колдонот. Бирок негизги PDFтин Methods бөлүмүндө логарифмдин негизи жана logSтин астында колдонулган баштапкы эригичтик бирдиги өзүнчө кайра аныкталбагандыктан, Verianla бул деталды булактан тышкары кошпойт.
AqSolDB окутуу маалыматтары
Изилдөөдө AqSolDB version 1.0 колдонулган. Жетишпеген жазуулар алынып салынып, алдын ала иштетүүдөн кийин маалыматтар топтому 9.982 уникалдуу органикалык кошулманы камтыйт. Ар бир кошулма SMILES сабы, InChIKey жана эксперименттик түрдө өлчөнгөн логарифмдик сууда эригичтик мааниси менен көрсөтүлөт.
| Уникалдуу кошулмалардын саны | 9.982 |
|---|---|
| Идентификация/структура көрсөтүлүштөрү | SMILES жана InChIKey |
| Максаттуу өзгөрмө | Эксперименттик сууда эригичтик, логарифмдик шкала |
| Минималдуу logS | −13.17 |
| Максималдуу logS | 2.14 |
| Орточо logS | −2.89 |
| Медианалык logS | −2.62 |
Булак AqSolDB бир нече адабият булагындагы эксперименттик байкоолорду бириктиргендиктен, маалыматтарда табигый ызы-чуу жана өзгөрмөлүүлүк пайда болорун белгилейт. Изилдөөчүлөр муну жалаң терс көрүнүш катары баалашпайт; бул реалдуу эрте этаптагы дары-дармек изилдөөлөрүндө ар башка өлчөө булактарынан келген гетерогендүүлүккө жакыныраак сценарий түзөрүн жүйө келтиришет. Ошол эле учурда бул өзгөчөлүк божомол катасына моделдин архитектурасы гана эмес, эксперименттик өлчөөлөрдүн айырмачылыктары да таасир этиши мүмкүн экенин билдирет.
Окутуу жана тышкы тест бөлүштүрүүлөрү эмне үчүн бирдей эмес?
Булактын Figure 3 сүрөтү окутуу маалыматтары менен ар түрдүү тышкы тест топтомдорунун logS бөлүштүрүүлөрү бирдей эмес экенин көрсөтөт. Klop120 окутуу бөлүштүрүүсүнө салыштырмалуу жакын болсо, Cui жана Boobier тар жана компакттуу бөлүштүрүүлөрдү көрсөтөт. Llinas1 жана Llinas2 болсо кеңирээк, көбүрөөк чачыраган жана төмөн эригичтик аймагына жылган бөлүштүрүүлөрдү көрсөтөт. Изилдөөчүлөр Llinas топтомдорундагы бул бөлүштүрүү жылышын моделдин жалпылоосу жагынан татаалыраак маселе катары баалашат.
Булактын Figure 4 сүрөтүндөгү t-SNE визуалдаштыруусу да тышкы маалыматтар топтомдорундагы көптөгөн кошулмалар окутуу үлгүлөрү камтыган химиялык мейкиндиктин ичинде же ага жакын жайгашканын; айрыкча айрым Llinas үлгүлөрү болсо тыгыз окутуу кластерлеринин айланасында же тышында болушу мүмкүн экенин көрсөтөт. Бул t-SNE графиги моделдин божомолдоо алгоритминин өзү эмес; маалыматтар топтомдорунун химиялык мейкиндиктеги салыштырмалуу орундарын визуалдаштыруу үчүн колдонулган түшүндүрмө проекция.
Молекулалык Дескриптор, Фингерпринт жана Mol2Vec Embedding Ортосунда Кандай Айырма Бар?
Молекулалык дескрипторлор молекуланын өлчөмүн, байланышын, электрондук же физика-химиялык касиеттерин сандык маанилер менен көрсөтөт; химиялык fingerprint-тер белгилүү структуралык мотивдердин бар-жогун көбүнчө 0/1 биттери менен коддойт; Mol2Vec болсо молекулалык ички түзүлүштөрдү Word2Vecке окшош түрдө үзгүлтүксүз вектордук мейкиндикте көрсөтүүнү үйрөнгөн embedding ыкмасы. Изилдөөнүн негизги идеясы — бул көрсөтүлүштөр бир эле химиялык түзүлүшкө ар башка көз караш бергени үчүн, жалгыз көрсөтүлүштүн ордуна бири-бирин толукташы мүмкүн.
MACCS fingerprint
MACCS key — молекулалык түзүлүштө белгилүү химиялык касиеттердин же ички түзүлүш мотивдеринин бар-жогун binary биттер менен көрсөткөн fingerprint ыкмасы. Биттин 1 болушу тиешелүү касиет бар экенин, 0 болушу жок экенин билдирет. Булак алдын ала иштетүүгө чейин 167 MACCS белгиси болгонун, тазалоодон кийин 112 белги калганын билдирет.
2D молекулалык дескрипторлор
Эки өлчөмдүү молекулалык дескрипторлор атомдордун үч өлчөмдүү конформациясын түз колдонбостон, молекуланын байланыш таблицасына таянат. Алар өлчөм, бутактануу, байланыш үлгүсү жана электрондук бөлүштүрүү менен байланышкан ар түрдүү сандык белгилерди түзө алат. Булакта 217 баштапкы белги алдын ала иштетүүдөн кийин 134кө азайган.
Mordred дескрипторлору
Mordred — cheminformatics изилдөөлөрүндө көп сандагы молекулалык дескрипторлорду эсептей ала турган descriptor программасы. Булак жалпысынан Mordred 1.800дөн ашык descriptor эсептей аларын билдирет. Бул изилдөө түзгөн белгилер матрицасында тазалоого чейинки Mordred белгилеринин саны 1.613, алдын ала иштетүүдөн кийин 451.
Mol2Vec
Mol2Vec — сөздөр үчүн иштелип чыккан Word2Vec логикасына окшош түрдө молекулалык ички түзүлүштөр үчүн тыгыз вектордук көрсөтүлүштөрдү үйрөнгөн көзөмөлсүз машиналык үйрөнүү ыкмасы. Молекуланын ички түзүлүштөрүнөн үйрөнүлгөн векторлорду бириктирүү аркылуу бүтүндөй молекула үчүн сандык embedding түзүлөт. Изилдөөдө 300 өлчөмдүү баштапкы көрсөтүлүштөн алдын ала иштетүүдөн кийин 185 белги калган.
PubChem fingerprint
PubChem fingerprint шакекче, атом жуптары жана башка структуралык мотивдердин бар экенин binary ички түзүлүш биттери менен көрсөтөт. Булакта изилдөөнүн башындагы 881 PubChem белгиси тазалоодон кийин 241 белгиге чейин азайганы айтылат.
| Көрсөтүлүш | Баштапкы белгилердин саны | Алдын ала иштетүүдөн кийин |
|---|---|---|
| MACCS | 167 | 112 |
| 2D descriptors | 217 | 134 |
| Mordred | 1.613 | 451 |
| Mol2Vec | 300 | 185 |
| PubChem | 881 | 241 |
Алдын ала иштетүү эмне үчүн маалыматтар бөлүнгөндөн кийин жүргүзүлгөн?
Машиналык үйрөнүүдө бардык маалыматтар боюнча белгилерди тандап, андан кийин окутуу-тест бөлүмүн түзүү тест маалыматтарынын статистикалык маалыматынын окутуу процессине кыйыр түрдө агып киришине алып келиши мүмкүн. Булак бул тобокелдикти азайтуу үчүн төмөн вариация жана жогорку корреляция фильтрлерин маалыматтар бөлүнгөндөн кийин жана ар бир окутуу fold-унун ичинде өз алдынча колдонгон. Окутуу fold-унда үйрөнүлгөн белгилердин кичи топтому андан кийин тиешелүү валидация/тест бөлүгүнө колдонулган.
VarianceThreshold мааниси 0.01 болуп колдонулган. Жетишпеген же чексиз маанилерди камтыган белгилер алынып салынып, андан соң корреляция коэффициенти 0.80ден жогору болгон ашыкча белгилер чыгарылган. Мындагы максат ызы-чууну жана кайталоону азайтуу менен бирге белгилерди тандоодо баалоо маалыматтарын алдын ала көрүп коюунун алдын алуу.
Stacking Негизиндеги Мета-Үйрөнүү Бул Изилдөөдө Кантип Иштейт?
Stacking ыкмасында бир эле регрессия моделинин божомолу акыркы жооп катары алынбайт; ар түрдүү базалык моделдердин out-of-fold божомолдору жаңы “meta-feature”ларга айландырылып, жогорку деңгээлдеги meta-learner бул божомолдорду бириктирүү аркылуу акыркы logS маанисин чыгарат. Бул изилдөөдө беш катмарлуу кайчылаш валидациянын аркасында ар бир окутуу үлгүсү үчүн meta-feature ошол үлгүнү окутуу учурунда көрбөгөн базалык модель тарабынан чыгарууга аракет жасалган; ошентип stacking катмарына окутуу максатын түздөн-түз жаттаткан маалыматтын агып кетиши азайтылган.
Out-of-fold божомол логикасы
Окутуу маалыматтары беш бөлүккө бөлүнгөн. Ар бир итерацияда төрт fold базалык моделди окутуу үчүн, калган fold болсо божомол чыгаруу үчүн колдонулат. Беш итерациянын аягында ар бир окутуу үлгүсү өзүн окутууда көрбөгөн моделден кеминде бир божомол алат. Бул божомолдор катар коюлуп, stacking мета-моделинин окутуу кириши түзүлөт.
Андан кийин оптималдаштырылган базалык моделдер бардык окутуу маалыматтарында кайрадан окутулат жана көз карандысыз тышкы тест топтомдору үчүн божомол чыгарат. Бул тышкы божомолдор да ошол эле тартипте stacking киришине айландырылат. Meta-learner базалык божомолдордон акыркы сууда эригичтик божомолун түзөт.
Салыштырылган 17 регрессия алгоритми
| Ыкмалар үй-бүлөсү | Алгоритмдер |
|---|---|
| Сызыктуу / robust / regularized | Bayesian Ridge, Ridge, Lasso, ElasticNet, Huber, Linear Regression |
| Kernel / instance / жалгыз дарак | Support Vector Regression, K-Nearest Neighbors, Decision Tree |
| Ensemble / boosting | Random Forest, Gradient Boosting, Histogram Gradient Boosting, AdaBoost, ExtraTrees, CatBoost, LightGBM, XGBoost |
Optuna бул жерде эмне кылат?
Optuna алгоритмдин өзүн өзгөрткөн божомол модели эмес, моделдин гиперпараметрлеринин ылайыктуу айкалыштарын издеген оптималдаштыруу framework-у. Булак тандалган күчтүү моделдер үчүн гиперпараметр оптималдаштыруу ар бир молекулалык encoding техникасына өз алдынча колдонулганын билдирет.
Бирок негизги PDF Optuna канча сыноо жүргүзгөнүн, кайсы гиперпараметрлер кайсы диапазондордо изделгенин, кайсы sampler/pruner конфигурациясы колдонулганын же оптималдаштыруунун random seed маанисин билдирбейт. Демек, ошол эле изилдөөнү бит деңгээлинде кайталоону каалаган окурман бул деталдардын баарын негизги PDFтен ала албайт.
Базалык моделдердин саны боюнча булак ичиндеги белгисиздик
Abstract, Discussion, Methods 4.5 жана Final features selection бөлүмдөрү CatBoost, ExtraTrees, Histogram Gradient Boosting жана XGBoost деген төрт атты берет. Ал эми Methods 4.6 “five top-performing machine-learning regression models”, Methods 4.8 болсо “five optimized base regressors” деген сөз айкашын колдонот. Негизги PDF бешинчи базалык алгоритмди ачык атабайт. Ошондуктан Verianla “бешинчи модель ушу” деген түрдө булактан тышкары толуктоо киргизбейт.
Methods 4.8де ошондой эле “mordered (order-sensitive) feature representations” деген сөз айкашы кездешет. Контекст мунун Mordred менен байланышкан жазуу көйгөйү болушу мүмкүн экенин көрсөткөнү менен, булак аны ачык оңдобогондуктан бул жерде так оңдоо жасалган эмес.
GroupKFold Эмне Үчүн Катуураак Жалпылоо Тести?
Бул изилдөөдөгү GroupKFold бирдей Bemis–Murcko негизги скелетин алып жүргөн молекулаларды бир fold ичинде кармап, окшош scaffold-тордун окутуу жана валидация тараптарында бир убакта болушуна жол бербөөгө аракет кылат; ошентип модель өтө жакын структуралык туугандарды жаттап алып жогорку натыйжа көрсөтүүнүн ордуна мурда көрбөгөн негизги chemotype-тарга жалпылоо жөндөмү кыйла катуу сыналат. Мунун акыбети катары, булактын натыйжаларында да көрүнгөндөй, айрым метрикалар Random Split же RepeatedKFold менен салыштырганда төмөн чыгышы мүмкүн.
Bemis–Murcko scaffold деген эмне?
Bemis–Murcko scaffold — молекуланын негизги шакекче жана байланыш скелетин көрсөтүү үчүн колдонулган структуралык кыскача сүрөттөмө. Изилдөөчүлөр RDKit аркылуу ар бир кошулманын scaffold-ун эсептеп, scaffold SMILES көрсөтүлүштөрүн түзүшкөн жана бирдей негизги түзүлүшкө ээ молекулаларды жалпы топ идентификатору астында бириктиришкен.
Андан кийин GroupKFold ушул топ белгилерин колдонуп, бир эле scaffold-дун ар башка fold-дорго бөлүнүшүнө жол берген эмес. Бул дизайн, өзгөчө химиялык окшоштук жогору маалыматтар топтомдорунда, окутуу-валидация агып кетишин азайтууга багытталган.
Маалыматтарды бөлүүнүн башка стратегиялары
Random Split үлгүлөрдү кокусунан бөлөт жана булакта эң төмөн окутуу RMSEсин берген; бирок структуралык жактан өтө окшош молекулалардын карама-каршы тараптарга түшүп калуу ыктымалдыгы бар.
RepeatedKFold k-fold процессин ар түрдүү кокустук бөлүнүүлөр менен бир нече жолу кайталайт. Максат — бир эле бөлүнүүнүн кокустугуна көз карандылыкты азайтуу.
ShuffleSplit маалыматтарды кайра-кайра аралаштырып, көз карандысыз окутуу-тест бөлүнүүлөрүн түзөт жана ар башка тандоо сценарийлеринде натыйжалуулуктун өзгөрмөлүүлүгүн изилдөөгө жардам берет.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Беш катмарлуу stacking окутуунун техникалык агымы
Окутуу маалыматтары болжол менен тең беш fold-ко бөлүнгөн. Ар бир циклде төрт fold базалык үйрөнүүчүнү окутуп, калган fold боюнча божомол чыгарылган. Беш fold-дун божомолдору бириктирилип, out-of-fold meta-feature матрицасы түзүлгөн. Ошентип мета-моделди окуткан божомолдор тиешелүү үлгүнү окутууда көрбөгөн базалык моделден келиши максат кылынган.
Meta-feature түзүү аяктагандан кийин оптималдаштырылган базалык моделдер бардык окутуу топтомунда кайра окутулуп, көз карандысыз тышкы тест топтомдору үчүн божомол чыгарышкан. Бул базалык божомолдорду бириктирүү аркылуу тест meta-feature матрицасы түзүлүп, акыркы logS божомолдору stacking мета-моделинен алынган.
Ар түрдүү split стратегияларындагы окутуу натыйжалуулугу
| Split стратегиясы | MAE | MSE | RMSE | R² |
|---|---|---|---|---|
| Random Split | 0.727 | 0.830 | 0.911 | 0.838 |
| RepeatedKFold | 0.745 | 0.871 | 0.933 | 0.842 |
| GroupKFold | 0.796 | 0.973 | 0.985 | 0.782 |
| ShuffleSplit | 0.739 | 0.857 | 0.926 | 0.823 |
Random Split эң төмөн RMSEни 0.911 менен берген, ал эми RepeatedKFold эң жогорку R² маанисин 0.842 менен берген. GroupKFoldдо R² 0.782ге чейин төмөндөп, RMSE 0.985ке чейин өсөт. Бул айырма GroupKFold “жаман ыкма” дегенди автоматтык түрдө билдирбейт; scaffold деңгээлиндеги окшоштукту өзүнчө fold-дорго өткөрбөгөндүктөн, баалоо маселеси татаалыраак болот.
Көз карандысыз тышкы тест топтомдору
| Тест топтому | n | Random Split | RepeatedKFold | GroupKFold | ShuffleSplit |
|---|---|---|---|---|---|
| Klop120 | 90 | 0.431 / 0.540 / 0.967 | 0.421 / 0.527 / 0.969 | 0.561 / 0.701 / 0.934 | 0.432 / 0.541 / 0.967 |
| Yalk21 | 20 | 0.192 / 0.240 / 0.985 | 0.170 / 0.213 / 0.988 | 0.295 / 0.363 / 0.937 | 0.211 / 0.265 / 0.982 |
| Boobier | 95 | 0.410 / 0.513 / 0.911 | 0.391 / 0.489 / 0.919 | 0.492 / 0.616 / 0.873 | 0.417 / 0.523 / 0.908 |
| Cui | 62 | 0.417 / 0.522 / 0.654 | 0.438 / 0.549 / 0.618 | 0.586 / 0.730 / 0.519 | 0.421 / 0.528 / 0.647 |
| Llinas2020 Set1 | 99 | 0.668 / 0.837 / 0.564 | 0.663 / 0.831 / 0.572 | 0.719 / 0.899 / 0.563 | 0.686 / 0.859 / 0.541 |
| Llinas2020 Set2 | 32 | 1.106 / 1.387 / 0.581 | 1.039 / 1.302 / 0.631 | 1.145 / 1.423 / 0.588 | 1.118 / 1.401 / 0.572 |
Klop120 маалыматтар топтомунун атында “120” болгону менен, булактын Table 2си бул баалоодо n=90 деп билдирет. Verianla таблицанын атынан улам үлгүлөрдүн санын 120га өзгөрткөн эмес.
RepeatedKFold; Klop120, Yalk21, Boobier жана эки Llinas топтомунда эң төмөн же эң жакшыга жакын каталар менен күчтүү натыйжа берет. Cuiде болсо Random Split R²=0.654 менен RepeatedKFoldдун 0.618 маанисинен жогору, RMSE=0.522 менен төмөн. Ошондуктан бир эле split стратегиясы бардык тест топтомдорунда бирдей артык деген жыйынтык чыгарууга болбойт.
MAE, MSE, RMSE жана R² Эмнени Түшүндүрөт?
MAE орточо абсолюттук божомол катасын, MSE каталардын квадраттарынын орточосун, RMSE MSEнин квадраттык тамырын жана ошону менен катаны кайра максаттуу өзгөрмөнүн logS шкаласына кайтарган чоңдукту, ал эми R² модель байкалган logS өзгөрмөлүүлүгүнүн канча бөлүгүн түшүндүрөрүн өлчөйт. MAE, MSE жана RMSE үчүн кичирээк; R² үчүн жалпысынан 1ге жакыныраак маани жакшыраак натыйжалуулукту билдирет, бирок бир эле метрика моделдин бүт ката түзүмүн түшүндүрбөйт.
Теңдеме 1: Орточо Абсолюттук Ката — MAE
\(\displaystyle MAE=\frac{1}{n}\sum_{i=1}^{n}|y_i-\hat{y}_i|\)
1. Формула эмнени эсептейт? Ар бир кошулма үчүн чыныгы logS менен моделдин божомолунун ортосундагы айырманын абсолюттук маанисин алып, бардык үлгүлөр боюнча орточосун эсептейт.
2. Өзгөрмөлөр кайсылар? \(n\) — үлгүлөрдүн жалпы саны; \(y_i\) — i-чи үлгүнүн эксперименттик/байкалган эригичтик мааниси; \(\hat{y}_i\) — ошол эле үлгү үчүн моделдин божомолу.
3. Бирдиги кандай? MAE максаттуу өзгөрмө менен бир эле шкалада берилет. Бул изилдөөдө максат logS болгондуктан, MAE да logS максат шкаласында. PDF logSтин баштапкы бирдигин өзүнчө аныктабагандыктан мындан ары физикалык бирдик кошулбайт.
4. Математикалык ролу кандай? Абсолюттук маани оң жана терс божомол каталарынын бири-бирин жокко чыгарышына жол бербейт. Ар бир ката чоңдугуна сызыктуу салмак берет.
5. Алгоритмдик мааниси кандай? Модель типтүү үлгүдө эксперименттик мааниден болжол менен канчалык четтей турганын түз окууга боло турган түрдө жыйынтыктайт.
6. Кайсы шартта жарактуу? Чыныгы жана божомол маанилери бир эле максат шкаласында болушу керек. Ар башка маалыматтар топтомдорунун максат бөлүштүрүүлөрү айырмаланса, MAEге гана карап жалпы жалпылоо сапатын толук түшүндүрүүгө болбойт.
7. Кантип чечмеленет? Төмөнүрөөк MAE орточо абсолюттук божомол четтөөсү кичирээк экенин көрсөтөт; бирок аз сандагы өтө чоң каталарды MSEдей күчтүү жазалабайт.
Теңдеме 2: Орточо Квадраттык Ката — MSE
\(\displaystyle MSE=\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2\)
1. Формула эмнени эсептейт? Ар бир божомол катасынын квадратын алып, квадраттык каталардын орточосун эсептейт.
2. Өзгөрмөлөр: \(n\), \(y_i\) жана \(\hat{y}_i\) MAE теңдемесиндеги маанилерин сактайт.
3. Бирдик: Максат шкаласынын квадраты; ошондуктан MSEни MAE же RMSE сыяктуу максат шкаласында түз окуу кыйын.
4. Математикалык ролу: Ката квадратка көтөрүлгөндүктөн, чоң четтөөлөр кичине четтөөлөргө караганда пропорциясыз чоң жаза алат.
5. Алгоритмдик мааниси: Өтө чоң божомол каталары кааланбаган маселелерде моделдин чоң четтөөлөрүнө сезгич сапат көрсөткүчү.
6. Шарт: MSEнин чоңдугу максаттуу өзгөрмөнүн шкаласына көз каранды; ар башка шкаладагы тапшырмаларды бир эле MSE саны менен түз салыштырууга болбойт.
7. Чечмелөө: Төмөн MSE жакшыраак, бирок квадратка көтөрүү себептүү бир нече экстремалдуу ката мааниси метриканы олуттуу жогорулата алат.
Теңдеме 3: Квадраттык Орточо Катанын Тамыры — RMSE
\(\displaystyle RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}\)
1. Формула эмнени эсептейт? MSEнин квадраттык тамырын алат.
2. Өзгөрмөлөр: \(n\), \(y_i\) жана \(\hat{y}_i\) мурунку теңдемелердегидей.
3. Бирдик: Квадраттык тамыр аркылуу максаттуу өзгөрмөнүн шкаласына кайтып келет; бул изилдөөдө logS максат шкаласында чечмеленет.
4. Математикалык ролу: Адегенде чоң каталарды квадратка көтөрүү менен баса белгилеп, андан соң квадраттык тамыр аркылуу жыйынтыкты кайра максат шкаласына алып келет.
5. Алгоритмдик мааниси: Чоң божомол каталарына MAEден сезгич, бирок MSEге караганда түз окууга ыңгайлуу ката метрикасы.
6. Шарт: Маалыматтар топтомунун бөлүштүрүлүшү жана экстремалдуу маанилер RMSEге таасир этиши мүмкүн; ошондуктан ар башка external set-тердеги RMSE айырмалары химиялык бөлүштүрүү айырмалары менен бирге бааланышы керек.
7. Чечмелөө: RMSEнин төмөндөшү жалпысынан жакшыраак божомол натыйжалуулугун көрсөтөт. Мисалы, Yalk21 RepeatedKFold RMSE=0.213 болсо, Llinas2020 Set2де 1.302; модель экинчи маалыматтар топтомунда кыйла жогорку ката чыгарат.
Теңдеме 4: Детерминация Коэффициенти — R²
\(\displaystyle R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}{\sum_{i=1}^{n}(y_i-\bar{y})^2}\)
1. Формула эмнени эсептейт? Моделдин квадраттык божомол катасын байкалган маанилердин өз орточосунан болгон жалпы квадраттык четтөөсү менен салыштырат.
2. Өзгөрмөлөр: \(y_i\) — чыныгы маани, \(\hat{y}_i\) — божомол, \(\bar{y}\) — байкалган максат маанилеринин орточосу жана \(n\) — үлгүлөрдүн саны.
3. Бирдик: Эки квадраттык сумманын катышы болгондуктан, R² өлчөмсүз.
4. Математикалык ролу: Алымдагы residual sum of squares азайган сайын катыш кичирейип, R² 1ге жакындайт.
5. Алгоритмдик мааниси: Моделдин божомолдору байкалган logS өзгөрмөлүүлүгүн канчалык деңгээлде түшүндүрөрүнүн кыскача көрсөткүчү.
6. Шарт: R² маалыматтар топтомунун максат бөлүштүрүүсүнө көз каранды болушу мүмкүн. Тар максат диапазону же distribution shift шартында бирдей RMSE ар башка R² жүрүм-турумун көрсөтүшү мүмкүн.
7. Чечмелөө: R²=1 идеалдуу шайкештикке туура келет. R²нин нөлгө жакындашы түшүндүрүү күчүнүн алсырашын, нөлдөн төмөн түшүшү болсо модель орточо маани менен божомолдоодон да жаман иштеши мүмкүн экенин көрсөтөт. Бул изилдөө тышкы тесттерде маалыматтар топтомуна жараша кыйла ар түрдүү R² маанилерин билдирет.
MetaModel, SolPredictor жана GGAS2SN салыштырылышы
| Маалыматтар топтому | MetaModel | SolPredictor | GGAS2SN |
|---|---|---|---|
| Boobier | 0.428 / 0.597 / 0.880 | 0.821 / 1.103 / 0.591 | 0.539 / 0.696 / 0.837 |
| Cui | 0.444 / 0.567 / 0.592 | 0.722 / 0.862 / 0.057 | 0.428 / 0.519 / 0.608 |
| Klop120 | 0.424 / 0.603 / 0.959 | 0.965 / 1.208 / 0.837 | 0.499 / 0.680 / 0.948 |
| Llinas set1 | 0.619 / 0.882 / 0.517 | 1.000 / 1.250 / 0.474 | 0.719 / 0.940 / 0.451 |
| Llinas set2 | 1.027 / 1.372 / 0.590 | 1.458 / 1.762 / 0.323 | 0.990 / 1.242 / 0.633 |
| Lovric1 | 0.511 / 0.780 / 0.807 | 0.625 / 0.783 / 0.803 | 0.655 / 0.794 / 0.775 |
| Yalk21 | 0.332 / 0.387 / 0.961 | 1.075 / 1.204 / 0.618 | 0.447 / 0.588 / 0.909 |
Бул таблица маанилүү бир нюансты көрсөтөт: MetaModel көп маалыматтар топтомдорунда күчтүү, бирок бардык маалыматтар топтомдорунда эң мыкты эмес. Cuiде GGAS2SN төмөнүрөөк MAE/RMSE жана жогорураак R² берет. Llinas set2де да GGAS2SNдин MAE, RMSE жана R² маанилери MetaModel-ден жакшыраак. Демек, авторлордун жалпы “robust” чечмелөөсүнө карабастан, булак таблицасындагы сандык мазмун ыкманын артыкчылыгы маалыматтар топтомуна көз каранды экенин көрсөтөт.
Table 2 жана Table 3 эмне үчүн бирдей сандарды бербейт?
Table 2 бир эле stacking MetaModel-ди ар башка split стратегиялары астында салыштырса, Table 3 MetaModel-ди SolPredictor жана GGAS2SN менен салыштырат. Жалпы маалыматтар топтомдорунда сандар так бирдей эмес; мисалы, Boobier үчүн Table 2де RepeatedKFold R²=0.919, ал эми Table 3тө MetaModel R²=0.880. Негизги PDF бул таблицалардын ортосундагы натыйжалуулук айырмасынын так баалоо конфигурациясын деталдуу шайкеш келтирбейт. Ошондуктан Verianla эки таблицаны бир эле натыйжалуулук таблицасы катары бириктирген эмес.
Статистикалык моделдик салыштыруулар
Изилдөөчүлөр ар бир үлгү боюнча абсолюттук божомол каталарына Wilcoxon signed-rank тесттерин жана paired t-test-терди колдонушкан. Boobier жана Cui маалыматтар топтомдорунда MetaModel-дин SolPredictor-го карата артыкчылыгы P<0.001 деп билдирилген. Boobier-де MetaModel менен GGAS2SN ортосундагы айырма P<0.05 деңгээлинде маанилүү. Cuiде болсо MetaModel менен GGAS2SN ортосунда P>0.05 болуп, статистикалык жактан маанилүү айырма билдирилген эмес.
Бул статистикалык натыйжалар Table 3тө Cui боюнча GGAS2SN сандык жактан бир аз жакшыраак метрикаларды бериши менен бирге окулушу керек: кичине метрикалык айырма статистикалык жактан маанилүү болбой калышы мүмкүн. Сандык артыкчылык менен статистикалык түрдө көрсөтүлгөн артыкчылык бир эле түшүнүк эмес.
Spearman жана Kendall корреляциялары
Булак кең logS динамикалык диапазонунда R²ге гана таянбоо үчүн Spearman rank correlation coefficient (ρ) жана Kendall's Tau (τ) да бааланганын билдирет. Klop120 үчүн Spearman ρ=0.97 жана Boobier үчүн ρ=0.95 ачык жазылган.
Бирок булак сүйлөмүнүн Yalk21 жана андан кийинки ρ=0.80 бөлүгүндө грамматикалык/форматтык бузулуу бар: “Yalk21 (ρ) ... (ρ = 0.80)” түзүлүшү 0.80 мааниси кайсы маалыматтар топтомуна так тиешелүү экенин ачык калтырат. Негизги текстте Kendall τ маанилеринин сандык таблицасы да көрсөтүлгөн эмес. Ошондуктан Verianla ρ=0.80 же τ үчүн булакта ачык берилбеген маалыматтар топтомунун дал келүүсүн жасабайт.
Predicted vs experimental logS графиктери эмнени көрсөтөт?
Булактын Figure 1 сүрөтү Boobier, Cui, Llinas set1 жана Klop120 маалыматтар топтомдорунда эксперименттик logS тенденциясы менен MetaModel, SolPredictor жана GGAS2SN божомолдорунун байланышын салыштырат. Авторлордун чечмелөөсүнө ылайык, MetaModel айрыкча болжол менен −4төн −2 logSке чейинки орто аймакта эксперименттик тенденцияга жакын жүрөт.
Өтө жогорку же өтө төмөн эригичтиктин четтеринде болсо божомол ийри сызыктары тегизделүү тенденциясын көрсөтөрү белгиленген. Бул модель экстремалдуу эригичтик өзгөрүүлөрүнө орто диапазондогудай сезгич болбошу мүмкүн экенин көрсөтөт. Figure 1дин чийки binned координаттары таблица түрүндө берилбегендиктен, Verianla графикти кайра чийип жаңы сандык чекиттерди чыгарбайт.
Figure 2 ката бөлүштүрүүсү жана булак ичиндеги сандык карама-каршылык
Figure 2 абсолюттук божомол каталарын үч аралыкка бөлөт: ≤0.5, 0.5<x≤1.0 жана >1.0. Визуалдагы белгилерде Boobier үчүн бөлүштүрүү болжол менен %69.35 / %22.58 / %8.06; Cui үчүн %72.63 / %14.74 / %12.63; Klop120 үчүн %72.22 / %21.11 / %6.67; Llinas set1 үчүн %60.61 / %19.19 / %20.2 болуп көрүнөт.
Бирок ошол эле сүрөттүн түшүндүрмөсүндө Klop120 үчүн ≤0.5 ката үлүшү %77.22 деп, мурунку натыйжа абзацында болсо болжол менен %77 деп жазылган. Визуалдык белги болсо %72.22. Бул булак ичиндеги дал келбестикти чечилген маалымат катары көрсөтүүгө болбойт. Ишенимдүү айтыла турган нерсе — Klop120де төмөн ката тобу басымдуу, ал эми Llinas set1де >1.0 ката тобу жогорураак.
Функционалдык топтордун бөлүштүрүлүшү эмнени түшүндүрөт?
Булактын Figure 5 сүрөтү hydroxyl, ether, carbonyl, halogen жана aromatic түзүлүштөрүнүн ортосундагы кабатташууларды көрсөтүп, окутуу маалыматтар топтомунун химиялык ар түрдүүлүгүн түшүндүрүүгө аракет кылат. Aromatic түзүлүштөрдүн көп болушу гидрофобдук шакекче системалары маалыматтар топтомунда кеңири таралганын; hydroxyl жана carbonyl сыяктуу полярдык функционалдык топтордун aromatic системалар менен бир молекулаларда чогуу болушу болсо көптөгөн кошулмалар гидрофобдук да, гидрофилдик да мүнөзгө ээ экенин көрсөтөт.
Авторлор hydroxyl жана carbonyl топтору суу менен hydrogen bonding же dipole–dipole өз ара аракеттери аркылуу эригичтикти колдошу мүмкүн экенин, ал эми галогендер липофилдүүлүктү жогорулатып эригичтикти азайтышы мүмкүн экенин талкуулашат. Бул түшүндүрмөлөр маалыматтар топтомунун курамын химиялык жактан чечмелеген жалпы механисттик framework; Figure 5 өзү эле белгилүү бир функционалдык топтун бул маалыматтар топтомунда эригичтикке себептик салымын өлчөбөйт.
Жогорку R² Модель Ар Бир Химиялык Мейкиндикте Ишенимдүү Дегенди Билдиреби?
Жок. Бул изилдөөдө Yalk21 жана Klop120 сыяктуу айрым тышкы топтомдордо R² болжол менен 0.97-0.99га жетсе, Llinas жана Cui сыяктуу бөлүштүрүүсү же химиялык мейкиндиги кыйыныраак топтомдордо R² кыйла төмөндөйт; демек, жогорку R² белгилүү бир баалоо маалыматтар топтомунда күчтүү шайкештикти көрсөтөт, бирок белгисиз бардык chemotype-тарда ошол эле тактык кепилденгенин билдирбейт. GroupKFold натыйжаларынын төмөн болушу жана Llinas топтомдорундагы жогорку каталар да структуралык бөлүштүрүүнүн өзгөрүшү жалпылоону кыйындатарын колдойт.
Изилдөөнүн күчтүү жактары
Биринчи күчтүү жагы — молекуланы бир гана encodingге мажбурлоонун ордуна binary fingerprints, классикалык descriptor-лор жана үйрөнүлгөн Mol2Vec embedding-дери чогуу бааланганы. Бул ыкма ар түрдүү көрсөтүлүш түрлөрүнүн бири-бирин толукташына мүмкүндүк берет.
Экинчи күчтүү жагы — 17 ар түрдүү регрессия алгоритми жалпы баалоо түзүлүшүндө салыштырылып, күчтүү моделдер Optuna менен өзүнчө оптималдаштырылганы.
Үчүнчү күчтүү жагы — stacking үчүн out-of-fold meta-feature түзүү колдонулганы. Бул дизайн мета-моделдин өзүнүн окутуу үлгүлөрүн көргөн базалык божомолдордон түз азыктануу тобокелдигин азайтууга багытталган.
Төртүнчү күчтүү жагы — бир гана random splitке ишенилбегени; Random Split, RepeatedKFold, GroupKFold жана ShuffleSplit натыйжалары чогуу каралган.
Бешинчи күчтүү жагы — модель AqSolDB окутуу мейкиндигинен тышкаркы көз карандысыз тест коллекцияларында бааланып, SolPredictor жана GGAS2SN сыяктуу мурдагы моделдер менен салыштырылганы.
Негизги чектөөлөр
Биринчи чектөө — маалыматтардын сапаты. AqSolDB көптөгөн адабият булактарындагы эксперименттик эригичтик өлчөөлөрүн бириктиргендиктен, ар башка лабораториялык шарттардан келип чыккан ызы-чуу жана гетерогендүүлүктү камтышы мүмкүн.
Экинчи чектөө — descriptor негизиндеги көрсөтүлүш татаал үч өлчөмдүү же алыс аралыктагы структуралык өз ара аракеттерди толук көрсөтө албашы мүмкүн. Булак авторлору келечектеги изилдөөлөр үчүн graph neural networks, transformer негизиндеги молекулалык embedding-дер жана pretrained molecular encoders сунушташат.
Үчүнчү чектөө — химиялык domain shift. Llinas маалыматтар топтомдорунда бөлүштүрүү окутуу мейкиндигинен көбүрөөк четтеп, божомол каталары өсөт.
Төртүнчү чектөө — моделдин экстремалдуу эригичтик аймактарында божомолдору тегизделип калышы мүмкүн; булак муну өтө жогорку же өтө төмөн logS маанилериндеги өзгөрүүлөргө сезгичтиктин төмөн болушу катары талкуулайт.
Бешинчи чектөө — негизги PDF айрым кайра өндүрүмдүүлүк деталдарын бербейт. Random seed, колдонулган эсептөө жабдуулары, Optuna сыноолорунун саны жана толук гиперпараметр издөө мейкиндиктери, stacking meta-learner-дин так алгоритми жана бардык final model гиперпараметрлери негизги текстте жок.
Алтынчы чектөө — базалык моделдердин санындагы булак ичиндеги дал келбестик: макаланын айрым бөлүмдөрү төрт атты берет, айрым Methods абзацтары беш базалык регрессор жөнүндө сөз кылат.
Жетинчи чектөө — Figure 2де Klop120 төмөн ката пайызынын графиктеги белгиси менен түшүндүрмө/тексттин дал келбеши.
Изилдөө колдогон чечмелөөлөр
- Бир нече молекулалык көрсөтүлүштү жана ensemble регрессия моделдерин stacking түзүлүшүндө бириктирүү сууда эригичтикти божомолдоодо күчтүү натыйжа бере алат.
- Модель айрым көз карандысыз тышкы маалыматтар топтомдорунда жогорку R² жана төмөн божомол катасын көрсөткөн.
- RepeatedKFold көптөгөн тышкы маалыматтар топтомдорунда күчтүү жана туруктуу натыйжаларды чыгарган.
- Scaffold негизиндеги GroupKFold структуралык жалпылоонун катуураак баалоосун сунуштайт.
- MetaModel SolPredictor-го салыштырмалуу Boobier жана Cuiде статистикалык жактан маанилүү деңгээлде төмөн ката көрсөткөн.
- Моделдин ийгилиги тышкы маалыматтар топтомунун химиялык бөлүштүрүлүшүнө көз каранды.
- Молекулалык encoding тандоосу жана маалыматтарды бөлүү стратегиясы натыйжалуулукту баалоонун маанилүү бөлүктөрү.
Изилдөө колдобогон чечмелөөлөр
- MetaModel бардык молекулаларда жана бардык маалыматтар топтомдорунда эң мыкты модель экени көрсөтүлгөн эмес.
- Модель эксперименттик эригичтик өлчөөсүн катасыз алмаштырарын далилдебейт.
- Жогорку R² бардык химиялык мейкиндиктерде бирдей жалпылоо натыйжалуулугун кепилдебейт.
- Descriptor же fingerprint-теги белгилүү бир касиеттин эригичтикке себептик таасирин бул модель салыштыруусунан өзүнчө чыгарууга болбойт.
- t-SNE графигиндеги жакындык түздөн-түз моделдин тактыгынын же химиялык себептүүлүктүн өлчөмү эмес.
- Table 2деги эң жакшы split натыйжасы менен Table 3төгү ыкма салыштыруу натыйжасын бир эле натыйжалуулук тажрыйбасы катары бириктирүүгө болбойт.
- Булакта түшүндүрүлбөгөн бешинчи базалык модель, meta-learner алгоритми же Optuna гиперпараметрлери божомол менен толтурулбашы керек.
Колдонмолук мааниси
Бул framework чоң молекула китепканаларындагы талапкерлерди эксперименттик тестке киргизерден мурун эсептөө жолу менен иреттөө, эрте дары табууда эригичтиги төмөн талапкердин тобокелдигин алдын ала баалоо жана молекулалык дизайн циклинде алдын ала тандоо жүргүзүү үчүн потенциалдуу курал. Бирок булак авторлору келечектеги изилдөөлөрдү көбүрөөк эксперименттик эригичтик маалыматтары, graph neural networks, transformer негизиндеги моделдер жана pretrained molecular encoders менен кеңейтүүнү да сунушташат.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: Integrating molecular descriptors and fingerprints via meta-learning for aqueous solubility prediction.
Авторлор жана ирети: Waqar Ahmad, Muhannad Dehni, Rida Arshad, Myunghum Park, Hilal Tayara, Ki-Duk Song.
Салым белгиси: Жүктөлгөн Article in Press PDF Waqar Ahmad, Muhannad Dehni жана Rida Arshad-ды “+ Contributing author” белгиси менен көрсөтөт. Булак “equal contribution” деген сөз айкашын ачык колдонбогондуктан тең салым деп божомолдонгон эмес.
Жооптуу авторлор: Myunghum Park, Hilal Tayara жана Ki-Duk Song.
PDFтеги мекеме 1: Department of Agricultural Convergence Technology, Jeonbuk National University, Jeonju, South Korea.
Мекеме 2: Research and Development Center, TNT Research, Sejong, South Korea.
Мекеме 3: Global Frontier College, Jeonbuk National University, Jeonju, South Korea.
Учурдагы расмий каттоодогу айырма: Natureдын учурдагы эрте жеткиликтүүлүк барагы Ki-Duk Song үчүн кошумча International Agricultural Development and Cooperation Center, Jeonbuk National University аффилиациясын көрсөтөт. Бул мекеме жүктөлгөн Article in Press PDFтин аффилиациялар тизмесинде жок.
Журнал: Scientific Reports.
Платформа: Nature Portfolio / nature.com.
Жарыя түрү: Article; accepted, peer-reviewed early-access / Article in Press версиясы.
Preprint статусу: Preprint эмес. Scientific Reports тарабынан кабыл алынган жана эрте жеткиликтүүлүккө чыгарылган рецензияланган изилдөө.
DOI: 10.1038/s41598-026-65722-y.
Келип түшкөн дата: 26 март 2026.
Кабыл алынган дата: 3 август 2026.
Учурдагы расмий жарыяланган дата: 19 август 2026.
Final версиянын статусу: Natureдын учурдагы барагы азыркы версия accepted research early-access версиясы экенин жана келечекте final Version of Record менен автоматтык түрдө алмаштырылаарын билдирет.
Том / final макала номери: Учурдагы эрте жеткиликтүүлүк каттоосунда final библиографиялык том/макала номери азырынча так көрсөтүлбөгөндүктөн, булактан тышкары маани кошулган эмес.
Лицензия: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International (CC BY-NC-ND 4.0).
Лицензиянын визуалдык натыйжасы: Булактагы Figure 1-6 түздөн-түз адаптацияланган же көчүрүлгөн эмес. Макаладагы inline SVG Methods текстиндеги фактылык процесстин ырааттуулугунан көз карандысыз түзүлгөн.
Каржылоо: Basic Science Research Program through the National Research Foundation of Korea, Ministry of Education, grant 2021R1I1A3057071; ошондой эле Regional Innovation System and Education (RISE) программасы, Jeonbuk RISE Center, Ministry of Education жана Jeonbuk State колдоосу, 2026-RISE-13-JBU.
Авторлордун салымы: W.A., M.D. жана R.A. тажрыйбаларды жүргүзгөн; M.P., H.T. жана K.D.S. натыйжаларды талдаган; бардык авторлор макаланы карап чыккан.
Маалыматтардын жеткиликтүүлүгү: Колдонулган жана/же талданган маалыматтар топтомдорун негиздүү суроо-талап боюнча corresponding author-дан алууга болору билдирилген.
Кызыкчылыктардын кагылышы: Авторлор competing financial interest жок экенин билдиришет.
Негизги маалымат булагы: AqSolDB version 1.0; алдын ала иштетүүдөн кийин 9.982 уникалдуу органикалык кошулма.
Молекулалык көрсөтүлүштөр: MACCS, 2D molecular descriptors, Mordred, Mol2Vec жана PubChem.
Модель үй-бүлөсү: 17 регрессия алгоритмин салыштыруу, Optuna гиперпараметр оптималдаштыруу жана stacking негизиндеги meta-learning.
Ачык аталган final базалык алгоритмдер: CatBoost, ExtraTrees, Histogram Gradient Boosting жана XGBoost.
Булак ичиндеги модель санынын дал келбестиги: Айрым Methods абзацтары “five” top-performing/base regressors сөз айкашын колдонсо, башка бөлүмдөр төрт гана алгоритмдин атын берет. Бешинчи алгоритм негизги PDFте ачык эмес.
Булак ичиндеги тексттик белгисиздик: Methods 4.8де “mordered (order-sensitive)” деген сөз айкашы бар; мунун эмнени билдирери булак тарабынан өзүнчө оңдолгон эмес.
Булак ичиндеги Figure 2 дал келбестиги: Klop120 үчүн ≤0.5 ката тобунун тегерек диаграммадагы белгиси %72.22 болсо, сүрөттүн түшүндүрмөсүндө %77.22 жана натыйжа текстинде болжол менен %77 деп берилет.
Rank-correlation чеги: Klop120 үчүн ρ=0.97 жана Boobier үчүн ρ=0.95 так; калган ρ=0.80 мааниси кайсы маалыматтар топтомуна тиешелүү экени булак сүйлөмүндөгү форматтык бузулуудан улам такталган эмес. Негизги текстте Kendall τ үчүн деталдуу сандык таблица берилбейт.
Кайра өндүрүмдүүлүк чеги: Негизги PDF exact random seed, Optuna trial саны жана деталдуу search space, эсептөө жабдуулары жана stacking meta-learner-дин так алгоритмин билдирбейт.
Негизги илимий чек: Изилдөө эсептөөчү QSPR/машиналык үйрөнүү божомолдоо изилдөөсү. Моделдин чыгыштары эксперименттик эригичтик өлчөөсү эмес жана жаңы химиялык мейкиндиктерде натыйжалуулук тышкы валидацияны талап кылат.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген